NVIDIA Vera Rubin NVL72 為承接 Grace Blackwell 世代的機櫃級 AI 運算系統,主要應用於大型模型訓練、推論及代理式 AI。其中,Vera 為 NVIDIA 自研的 Arm 架構 CPU,Rubin 為新一代 GPU,NVL72 則代表單一 NVLink 高速互連網域內整合 72 顆 GPU。其核心設計在於協同最佳化 GPU、CPU、記憶體、網路、供電與散熱,使整座機櫃形成緊密協作的運算系統,降低大型模型運算過程中跨處理器資料傳輸、同步及等待所耗費的時間。
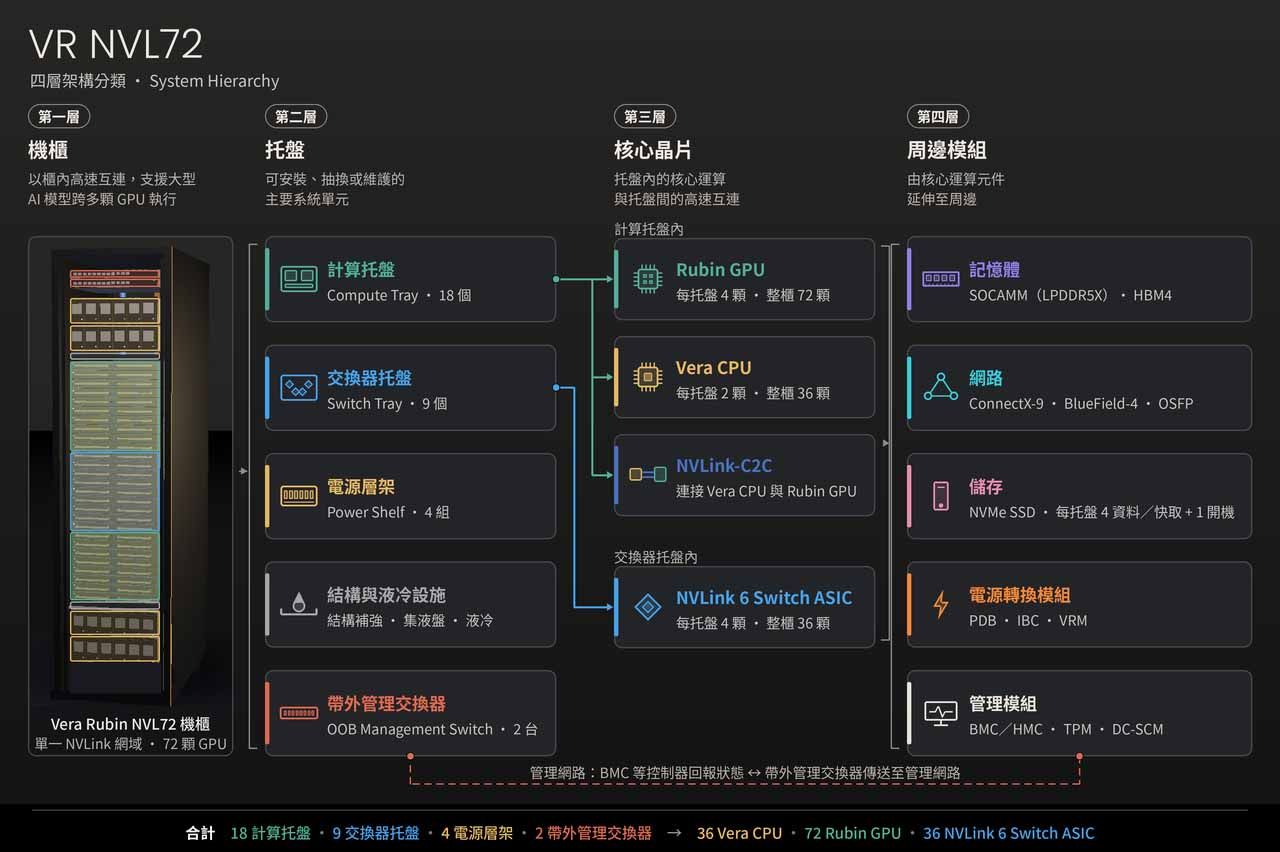
本文聚焦於 Vera Rubin NVL72 計算機櫃;完整的 Vera Rubin 平台則進一步涵蓋外部網路、儲存及其他專用運算機櫃。本文將機櫃結構拆解成四層,由大到細,一一講解其組成與功能。
- 機櫃為 Vera Rubin NVL72 的第一層架構,主要透過櫃內高速互連,支援大型 AI 模型跨多顆 GPU 執行,將模型權重、運算工作與中間結果分配至不同 GPU 協同處理。
- 第二層架構涵蓋計算托盤、交換器托盤、電源層架、帶外管理交換器,以及結構與液冷設施,構成機櫃內可安裝、抽換或維護的主要系統單元。
- 第三層架構涵蓋 Vera CPU、Rubin GPU、NVLink-C2C 與 NVLink 6 Switch ASIC,負責托盤內的核心運算及托盤間的高速互連。
- 第四層架構由核心運算元件延伸至周邊,涵蓋記憶體、網路、儲存、電源轉換與管理模組。
Vera Rubin 機櫃透過高速互連實現跨單元協同運算
機櫃為 Vera Rubin NVL72 的第一層架構,主要透過櫃內高速互連,支援大型 AI 模型跨多顆 GPU 執行,將模型權重、運算工作與中間結果分配至不同 GPU 協同處理。
Vera Rubin NVL72 採用 48U MGX 機櫃架構,依圖示配置,18 個 1U 計算托盤分布於機櫃中段的上下兩區,中央配置 9 個 1U NVLink 交換器托盤,並整合 4 組 3U 電源層架、頂部 2 台帶外管理交換器,以及結構補強、集液與液冷系統。每個計算托盤搭載 2 組 Vera Rubin Superchip,每組由 1 顆 Vera CPU 與 2 顆 Rubin GPU 透過 NVLink-C2C 高速互連,因此單一托盤包含 2 顆 CPU 與 4 顆 GPU,整櫃合計配置 36 組 Superchip、36 顆 CPU 及 72 顆 GPU。Superchip 代表 CPU 與 GPU 緊密互連的整合運算單元,並非單一裸晶;每顆 Rubin GPU 封裝內另含 2 顆主要運算裸晶,因此整櫃共對應 144 顆主要 GPU 運算裸晶。中央的交換器托盤各搭載 4 顆 NVLink 6 Switch ASIC,整櫃合計配置 36 顆交換晶片,構成連接 72 顆 GPU 的高速互連網域。計算托盤內另整合 CPU 使用的 LPDDR5X 記憶體、GPU 使用的 HBM4 記憶體、ConnectX-9 網路晶片、BlueField-4 DPU、NVMe SSD,以及電源轉換與管理模組;機櫃背面則配置 NVLink 銅纜背板、供電匯流排、液冷歧管與接頭,透過運算、互連、供電及散熱的協同設計,支援整櫃高密度運算與日常維護需求。
Vera Rubin 機櫃內含計算托盤、交換器托盤、電源層架等架構
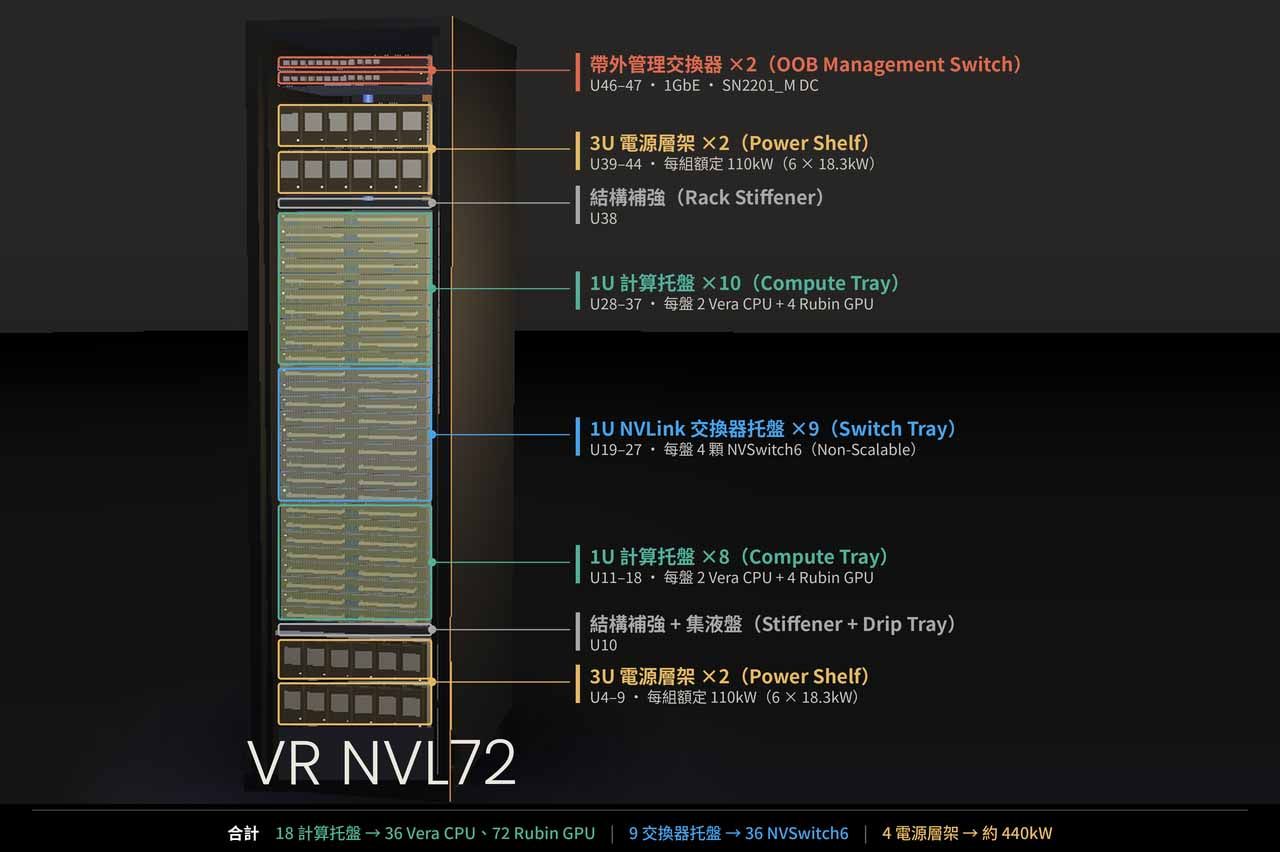
第二層架構涵蓋計算托盤、交換器托盤、電源層架、帶外管理交換器,以及結構與液冷設施,構成機櫃內可安裝、抽換或維護的主要系統單元。(上述為參考架構;不同 OEM 的實際配置仍可能調整)
| 第二層單元 | 每櫃配置 | 主要工作 |
|---|---|---|
| 計算托盤 (Compute Tray) | 18 個,每個 1U | 容納 CPU、GPU、記憶體、網路及儲存模組,執行運算 |
| NVLink 交換器托盤 (Switch Tray) | 9 個,每個 1U | 串接全櫃計算托盤的 GPU,組成單一 NVLink 網域 |
| 電源層架 (Power Shelf) | 4 組,每組 3U、額定 110 kW | 將外部電力轉換為機櫃使用的直流電 |
| 帶外管理交換器 (OOB Management Switch) | 2 台 | 傳送硬體監控、韌體與遠端管理訊息 |
| 結構補強、集液與液冷系統 | 分布於機櫃及托盤內 | 支撐與定位零組件、分配冷卻液、帶走熱量 |
計算托盤 (Compute Tray) 整合雙 Superchip,透過模組化設計串聯運算與周邊系統
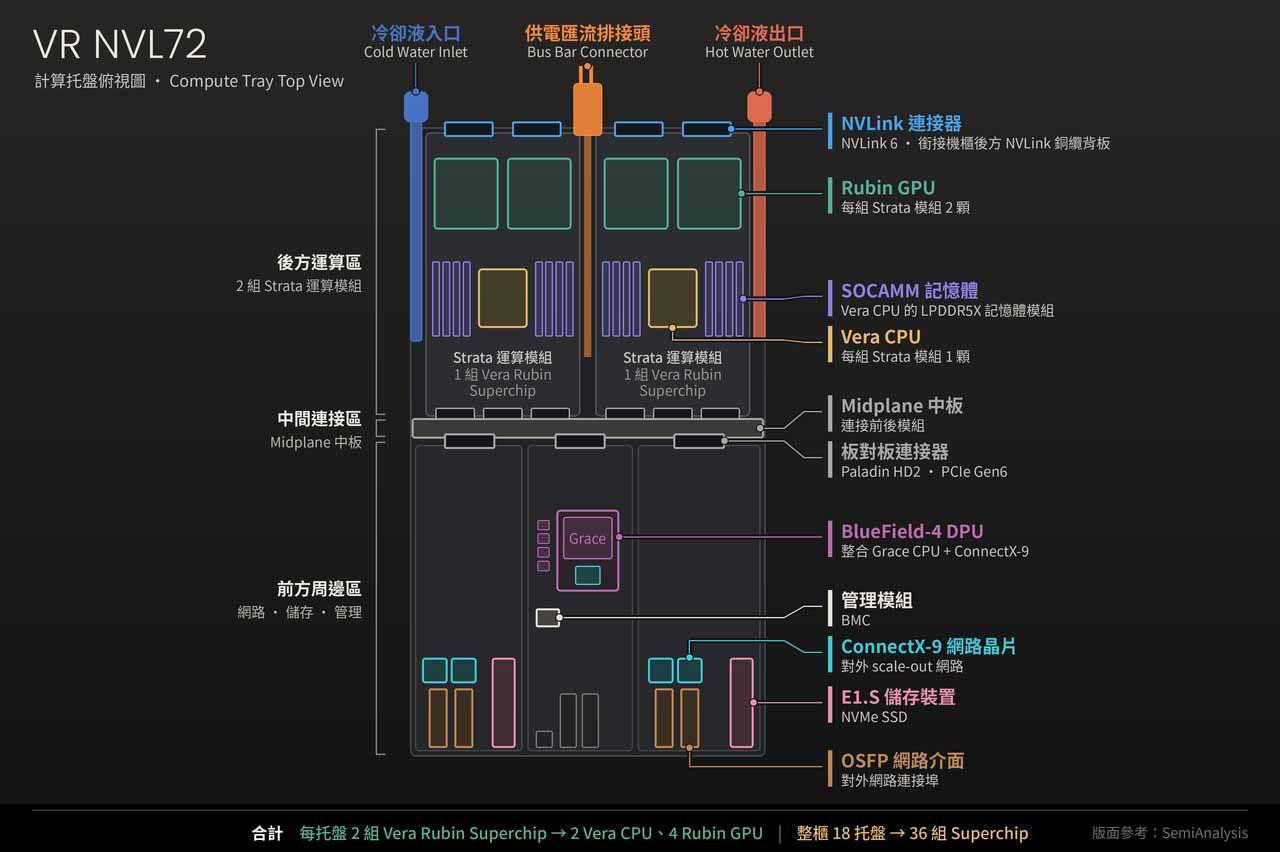
計算托盤為承載 Vera Rubin NVL72 主要運算元件的系統單元,每個托盤配置 2 顆 Vera CPU 與 4 顆 Rubin GPU,依圖示可分為後方運算區、中間連接區及前方周邊區。後方由兩組 Strata 運算模組構成,每組搭載 1 顆 Vera CPU、2 顆 Rubin GPU 及相關記憶體,並透過尾端的 NVLink 連接器與供電匯流排接頭,銜接機櫃內的高速互連與供電系統;中間配置 Midplane 中板,連接前後模組;前方則整合 ConnectX-9 網路晶片、OSFP 網路介面、E1.S 儲存裝置及管理模組,托盤兩側另設有冷卻液入口與出口,支援液冷散熱。每組由 1 顆 Vera CPU 與 2 顆 Rubin GPU 組成的運算單元稱為 Vera Rubin Superchip,因此單一托盤包含 2 組 Superchip,整櫃 18 個計算托盤合計搭載 36 組;Superchip 代表 CPU 與 GPU 緊密互連的整合運算單元,並非將三顆處理器合併為單一裸晶。 整體採模組化插接設計,透過中板與板對板連接器,減少托盤內需逐條安裝的線纜,提升組裝與維修便利性;機櫃後方的 NVLink 銅纜背板及對外網路連線則仍為系統互連的重要組成。
交換器托盤 (Switch Tray) 整合 NVLink 6 交換晶片,支援 72 顆 GPU 高速互連
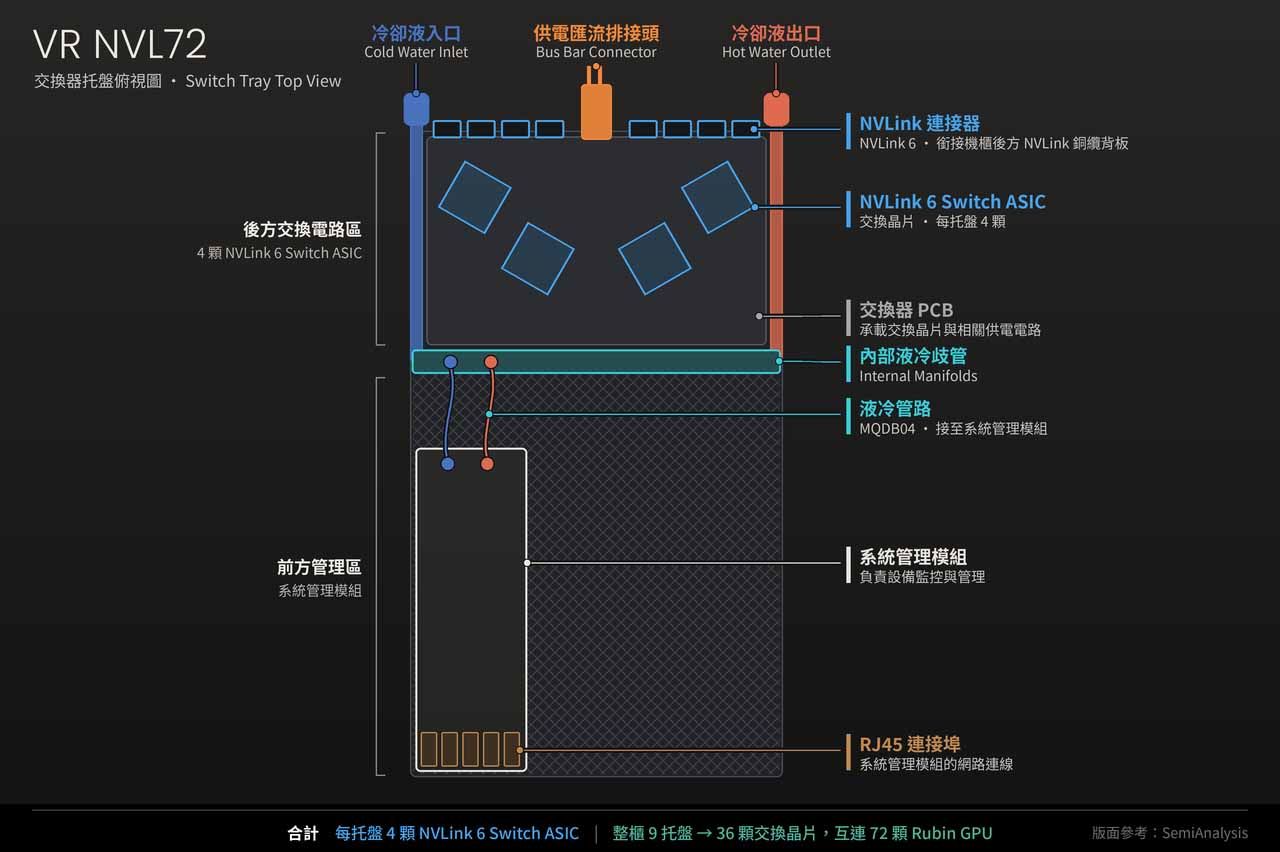
交換器托盤為 Vera Rubin NVL72 機櫃內負責 GPU 間資料交換的系統單元,每個托盤搭載 4 顆 NVLink 6 Switch ASIC,整櫃 9 個托盤合計配置 36 顆交換晶片。依圖示,托盤後方為主要交換電路區,配置交換晶片、交換器 PCB 及相關供電電路,尾端設有 NVLink 連接器與供電匯流排接頭,分別銜接機櫃後方的 NVLink 銅纜背板與供電系統;兩側配置冷卻液入口及出口,並透過內部液冷歧管、管路與冷板帶走元件運作產生的熱量,前方則設有系統管理模組,負責設備監控與管理。計算托盤內的 GPU 透過銅纜背板連接至交換晶片,由各交換器托盤共同構成涵蓋 72 顆 GPU 的 NVLink 高速互連網域,支援不同計算托盤之間交換模型資料與運算結果。其中,交換器托盤是整合交換、供電、管理及散熱元件的可安裝與維護設備,交換晶片則是托盤內實際執行資料交換的 ASIC,兩者分屬系統設備與核心元件的不同層級。
電源層架 (Power Shelf) 將交流電轉為 54V 直流電,透過匯流排供應各托盤用電
電源層架負責機櫃層級的電力轉換,依現行 DGX 文件,每組額定容量為 110 kW,內含 6 個約 18.3 kW 的 PSU,將 415–480V AC 轉換為 54V DC,再透過機櫃供電匯流排配送至各托盤。整櫃配置 4 組電源層架,合計 24 個 PSU,額定容量共 440 kW。此數值代表電源設備的總容量,實際耗電仍取決於工作負載、功率設定及其他元件負載,可用供電能力亦須考量備援配置。電力進入托盤後,再由電源轉換模組進一步降壓至各晶片所需的工作電壓。
帶外管理交換器 (OOB Management Switch) 串聯硬體管理介面,支援獨立監控與遠端維護
帶外管理交換器負責串聯機櫃內各裝置的硬體管理介面,透過獨立的管理路徑,支援遠端開關機、溫度與電壓監控、韌體更新及故障紀錄讀取等功能。只要管理控制器與管理網路維持供電且正常運作,即使主機作業系統無回應,管理人員仍可透過此路徑檢查設備狀態,並視情況執行重啟。機櫃頂端的兩台帶外管理交換器,連接計算托盤、BlueField-4 及交換器托盤的管理控制器,主要承載設備監控與維護所需的管理訊息;大量 AI 運算資料則透過 NVLink 或 ConnectX-9 所連接的運算網路傳輸。因此,帶外管理交換器與 GPU 使用的高速交換網路,在設備功能與傳輸內容上具有明確區別。
散熱架構涵蓋機櫃、托盤與晶片三層級,涵蓋液冷與氣冷設計
Vera Rubin NVL72 的散熱系統可由大至小分為機櫃、托盤及晶片與元件三個層級。
- 第一層為機櫃級,涵蓋供液與回液歧管、管路及快速接頭,負責將冷卻液分配至各托盤,並將吸收的熱量帶往機櫃外的冷卻液分配單元 CDU,另包含供電匯流排的液冷與電源供應器的風扇氣冷。
- 第二層為托盤級,涵蓋計算托盤與交換器托盤內的分流管路、接頭及整合式冷板模組,將冷卻液導向 CPU、GPU、記憶體、網路晶片與交換器晶片等發熱區域。
- 第三層為晶片與元件級,涵蓋晶片散熱上蓋、導熱介面材料 TIM、冷板接觸面及內部流道,透過導熱與熱交換將晶片產生的熱量傳遞至冷卻液;採氣冷的元件則經由導熱材料與散熱片,將熱量傳遞至氣流並帶離元件。
| 層級 | 主要散熱零組件 | 功能與涵蓋範圍 |
|---|---|---|
| 第一層:機櫃級 | 供液與回液歧管、管路、快速接頭、匯流排液冷結構、電源供應器風扇 | 分配與回收各托盤的冷卻液,將熱量送往機櫃外的 CDU;同時涵蓋供電匯流排的液冷與電源供應器的氣冷。 |
| 第二層:托盤級 | 托盤內部分流管路、接頭、整合式冷板模組 | 在計算托盤與交換器托盤內,將冷卻液導向 CPU、GPU、記憶體、網路晶片、交換器晶片及供電元件等發熱區域。 |
| 第三層:晶片與元件級 | 晶片散熱上蓋、導熱介面材料(TIM)、冷板接觸面與內部流道、散熱片 | 將晶片與元件的熱量傳入冷板,再由冷卻液帶走;採氣冷的元件則透過導熱材料與散熱片,將熱量交由氣流帶走。 |
Vera Rubin 第三層架構整合核心運算與高速互連,支援托盤內外協同運作
第三層架構涵蓋 Vera CPU、Rubin GPU、NVLink-C2C 與 NVLink 6 Switch ASIC,負責托盤內的核心運算及托盤間的高速互連。 其中,Vera CPU 與 Rubin GPU 配置於計算托盤,NVLink-C2C 為連接 CPU 與 GPU 的介面及通訊協定;NVLink 6 Switch ASIC 則配置於交換器托盤,支援不同計算托盤內 GPU 之間的資料交換。
Vera CPU 承擔系統控制與資料處理,支援 CPU 與 GPU 協同運算
Vera CPU 配置於計算托盤,負責系統控制、資料處理及各類 CPU 工作負載,每個托盤搭載 2 顆,整櫃共 36 顆。 每顆 Vera 配備 88 個 NVIDIA 自研 Olympus 核心,支援 176 個硬體執行緒,整櫃合計提供 3,168 個核心與 6,336 個執行緒。在 AI 系統中,Vera 主要承擔資料前處理、控制程式執行、工作排程及 I/O 處理,並協調 CPU 與 GPU 之間的資料交換。隨著代理式 AI 與強化學習應用發展,程式編譯、工具呼叫、環境模擬及結果驗證等任務亦增加 CPU 處理需求;若這些環節形成瓶頸,即使 GPU 仍有可用算力,也可能因等待資料或控制流程而閒置,因此 CPU 處理能力與互連效率同樣影響整體系統的運算利用率。
Rubin GPU 採雙裸晶設計,支援大規模平行運算與 AI 矩陣加速
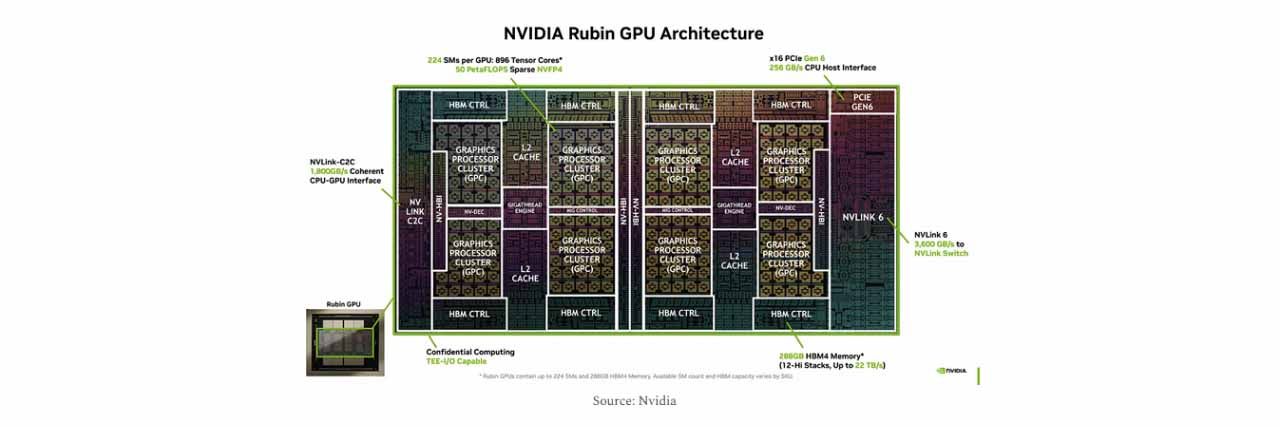
Rubin GPU 同樣配置於計算托盤,負責大量平行運算與 AI 矩陣運算,每組 Vera Rubin Superchip 搭載 2 顆,每個計算托盤配置 4 顆,整櫃合計 72 顆。 單顆 Rubin GPU 採雙運算裸晶封裝設計,透過 NV-HBI 高速互連,整合約 3,360 億個電晶體,最高配置 224 個串流多處理器 SM 與 896 個 Tensor Core。效能方面,單顆 Rubin GPU 的 NVFP4 密集運算峰值為 35 PFLOPS,稀疏推論運算峰值為 50 PFLOPS。實際運算效能除取決於峰值算力,亦受到記憶體資料供應速度及跨 GPU 通訊效率影響,兩者共同決定 GPU 能否持續維持高運算利用率。
NVLink-C2C 串聯 CPU 與 GPU,NVLink 6 支援跨 GPU 資料交換
NVLink-C2C 與 NVLink 6 Switch ASIC 分別負責 CPU 與 GPU 之間的一致性互連,以及 GPU 之間的資料交換。NVLink-C2C 連接 Vera CPU 與 Rubin GPU,由處理器上的介面電路、實體連線及通訊協定共同構成,屬於高速互連介面。官方於 Vera Rubin Superchip 層級列出的 NVLink-C2C 頻寬為 1.8 TB/s,除支援高速資料傳輸外,亦提供一致性記憶體存取,讓 CPU 與 GPU 協同使用記憶體,降低資料交換與同步的管理負擔,串聯資料處理、控制流程及 GPU 運算。
NVLink 6 Switch ASIC 則配置於交換器托盤,每個托盤搭載 4 顆,整櫃合計配置 36 顆。當模型分散於多顆 GPU 執行時,這些交換晶片負責將資料傳送至目的 GPU,支援模型平行、專家路由、梯度交換及集合通訊。
| 互連 | 連接對象 | 在系統中的作用 |
|---|---|---|
| NVLink-C2C | Vera CPU ↔ Rubin GPU | CPU 與 GPU 協作、資料交換及一致性記憶體存取 |
| NVLink 6 | Rubin GPU ↔ NVLink Switch ↔ 其他 Rubin GPU | 建立整櫃 72 顆 GPU 的高速互連網路 |
Vera Rubin 第四層架構涵蓋記憶體、網路、電源轉換與管理等模組
第四層架構由核心運算元件延伸至周邊,涵蓋記憶體、網路、儲存、電源轉換與管理模組。 其中,HBM4 整合於 GPU 封裝內,LPDDR5X 配置於 CPU 旁的記憶體模組,其餘元件則主要分布於托盤內的板卡及周邊模組。
| 元件 | 實際所在位置 | 參考配置下的數量 |
|---|---|---|
| Vera 使用的 LPDDR5X | Strata 板上的 SOCAMM 模組 | 每 CPU 8 個模組,整櫃 288 個 |
| Rubin 使用的 HBM4 | GPU 封裝內 | 每 GPU 8 個堆疊,整櫃 576 個 |
| 主機 NVMe SSD | 計算托盤的資料/快取與開機槽位 | 每托盤 4+1 個,整櫃 90 個槽位 |
| 獨立 ConnectX-9 | 計算托盤前方網路模組 | 每托盤 8 顆,整櫃 144 顆 |
| BlueField-4 DPU | 計算托盤前方 DPU 模組 | 每托盤 1 組,整櫃 18 組 |
| 電源轉換模組 | 電源配送板及各功能板卡 | 包含 PDB、IBC、VRM,依板卡配置 |
| 管理模組 | 計算、交換器及其他裝置模組 | 分散配置 BMC/HMC、管理與安全元件 |
LPDDR5X 與 HBM4 分別支援 CPU 容量需求與 GPU 高頻寬存取
LPDDR5X 與 HBM4 分別為 Vera CPU 與 Rubin GPU 使用的記憶體,兩者在配置、容量、頻寬及維修方式上各有差異。LPDDR5X 為記憶體技術規格,SOCAMM 則是承載記憶體的可拆換模組形式,兩者屬於不同分類。 依附件配置,每顆 Vera CPU 搭配 8 個 SOCAMM,分布於 CPU 兩側,用於存放執行中的程式、工作資料與運作狀態,亦可透過 CPU 與 GPU 互連,支援需要較大記憶體容量的工作負載。每顆 Vera 的記憶體容量最高約 1.5 TB、頻寬最高約 1.2 TB/s,整櫃 CPU 記憶體容量最高約 54 TB;可拆換模組設計則有助於縮小記憶體故障時的維修更換範圍。
HBM4 為整合於 Rubin GPU 封裝內、鄰近運算裸晶的高頻寬記憶體,透過記憶體堆疊與寬介面提供高速資料傳輸,主要存放模型權重、運算中間結果及推論使用的 KV cache。依附件配置,每顆 Rubin 搭載 8 個 HBM 堆疊,單顆 GPU 記憶體容量為 288 GB、頻寬為 19.2 TB/s,整櫃容量約 20.7 TB。其中,容量決定可容納的模型與工作資料規模,頻寬則決定資料供應至 GPU 的速度;當 GPU 反覆讀取模型權重與 KV cache 時,HBM 的資料供應能力將直接影響運算單元的等待時間與利用率。由於 HBM 屬於 GPU 封裝的一部分,其維修與更換方式亦不同於可拆換的 SOCAMM。
NVMe SSD 提供托盤內持久儲存
NVMe SSD 提供計算托盤內的非揮發性儲存,其中 NVMe 為儲存通訊協定,E1.S 則為 SSD 的外形規格。依現行配置,每個計算托盤設有 4 個資料/快取 SSD 槽位及 1 個主機開機 SSD 槽位,整櫃分別為 72 個與 18 個,合計 90 個主機 SSD 槽位。開機 SSD 用於存放作業系統與相關軟體,資料/快取 SSD 則支援本地資料暫存、模型載入及快取。相較於 HBM 與 LPDDR5X,SSD 可提供較大容量的持久儲存空間,但存取延遲較高、頻寬較低,因此 SSD、CPU 記憶體與 GPU 記憶體各自承擔不同層級的資料儲存與存取需求,並由軟體協調資料在各層之間的移動。
電源轉換模組滿足晶片低電壓、大電流需求
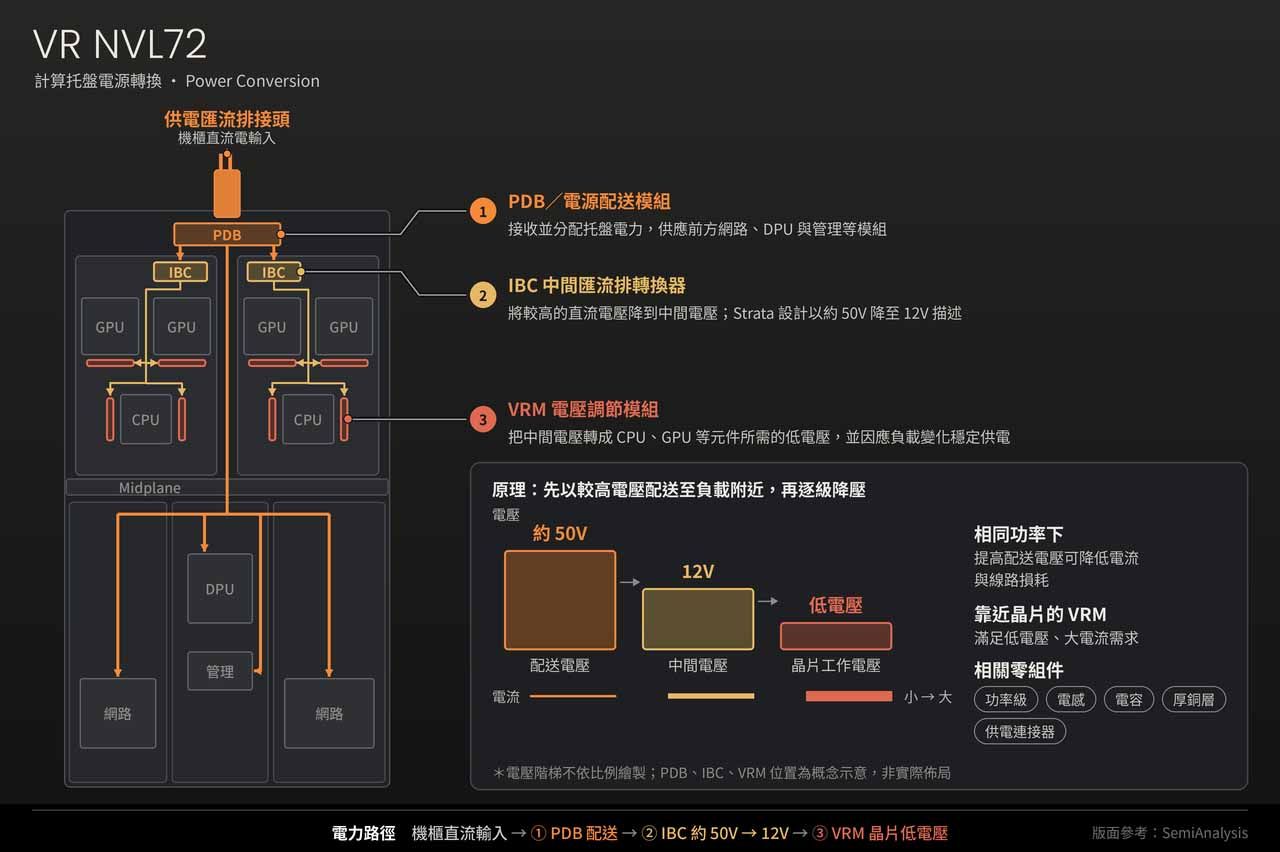
電源轉換模組負責將機櫃輸入的直流電轉換為各晶片所需的工作電壓,主要涵蓋電源配送、中間電壓轉換及末端穩壓三項功能:
- PDB/電源配送模組: 接收並分配托盤電力,供應前方網路、DPU 與管理等模組。
- IBC,中間匯流排轉換器: 將較高的直流電壓降到中間電壓;附件的 Strata 設計以約 50V 降至 12V 描述。
- VRM,電壓調節模組: 再把中間電壓轉成 CPU、GPU 或其他元件所需的低電壓,並因應負載變化穩定供電。
原理為先以較高電壓將電力配送至接近負載的位置,再逐級降壓;在相同功率下,提高配送電壓可降低電流與線路損耗,靠近晶片的 VRM 則負責滿足低電壓、大電流的供電需求。相關零組件包括功率級、電感、電容、厚銅層及供電連接器,共同支撐電力轉換與配送。
管理模組透過帶外網路支援設備維護
管理模組負責監測硬體狀態、執行控制及建立安全信任機制。計算托盤透過 BMC/HMC 等控制器進行硬體監控、保存事件紀錄,並提供遠端管理介面。其中,BMC 著重硬體監控與控制,TPM 提供安全金鑰保護、完整性量測及信任功能,DC-SCM 則將部分管理與安全控制功能整合為模組。交換器托盤亦配置自身的管理與安全元件,因此整櫃管理系統由分布於各托盤的控制器與模組共同構成。
此層架構與帶外管理交換器直接銜接:BMC 等控制器負責取得設備狀態及執行管理命令,帶外管理交換器則負責將相關訊息傳送至管理網路。例如,當托盤偵測到溫度異常時,管理控制器會記錄事件並回報,供管理系統進一步診斷及安排維護。
結論
透過機櫃、托盤、核心晶片與周邊模組的逐層拆解,可看出 NVIDIA Vera Rubin NVL72 以整櫃協同運作為設計核心。計算托盤整合 CPU、GPU 與記憶體,交換器托盤建立跨 GPU 的高速通訊網路,供電與散熱系統支撐高密度負載下的持續運算,管理模組則提供硬體監控、故障診斷與遠端維護功能。各層元件透過資料傳輸、電力配送、冷卻循環及管理網路緊密連結,將個別元件的功能整合為完整的機櫃級 AI 運算能力。
