OCP(Open Compute Project)是由 Meta、Intel、Rackspace 與高盛等企業於 2011 年共同發起的開源硬體計畫,旨在打破傳統伺服器與資料中心硬體規格的封閉性,透過開放伺服器、儲存設備、機櫃設計及資料中心基礎設施等技術規格,促進全球科技業者與供應鏈共同開發,推動硬體標準化與系統互通性。 OCP Global Summit 則是該組織每年舉辦的年度旗艦盛會,匯聚全球Hyperscalers、晶片大廠及硬體製造商,展示並交流 AI 伺服器、資料中心供電、液冷散熱與高速網路等關鍵技術。2026 年 OCP Global 以「Scaling Innovation for the AI Era」為主題,隨著 AI 發展逐步邁向 Agentic AI,模型不僅需要更強的運算能力,也對推論效率、記憶體容量與頻寬,以及叢集內部的資料傳輸提出更高要求。本次展會的技術焦點在光通訊、正交背板交換器、3.5D 先進封裝及記憶體等領域,反映 AI 基礎設施正從單一晶片的效能競爭,轉向運算、傳輸、記憶體與電力散熱的整體系統升級。
光互連迎接 AI 算力擴張:NPO 與開放架構受關注
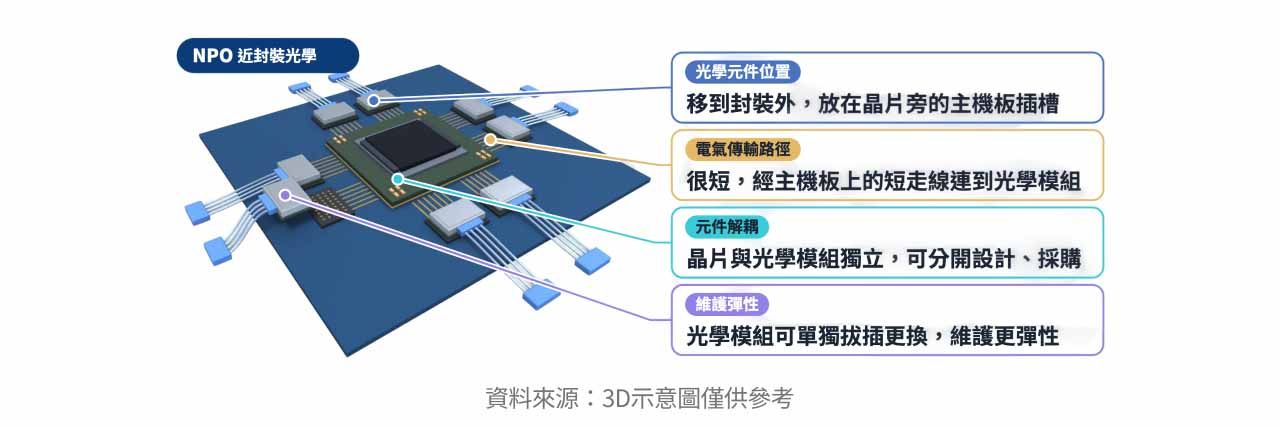
光通訊技術是本次 2026 年 OCP Global Summit 的重要主軸,反映隨著 AI 模型規模、加速器數量及資料中心運算密度持續提高,系統瓶頸正逐漸延伸至資料傳輸與互連效率。 在峰會第二天,IPEC 舉辦光互連研討會,Source Photonics、LightCounting、阿里巴巴、Meta、Oracle、微軟、Ciena、Lumentum、NVIDIA 及華為等業者皆有出席。此次會議聚焦近封裝光學(NPO)的技術發展與商業化前景,NPO 將光學元件配置於更靠近運算或交換晶片的位置,以縮短電氣傳輸路徑、提升頻寬密度並降低功耗。相較於共同封裝光學(CPO),NPO 在元件解耦與維護彈性方面具備優勢。 此外,Open CPX 等開放式架構也受到關注,期望透過統一跨供應商介面,降低設備整合難度。
第三天論壇則聚焦光子技術(Photonics),NVIDIA、Meta、微軟、Oracle、博通(Broadcom)、Celestica、Arista、Ciena、Amphenol、Lumentum 及華為等業者分享技術發展方向。業界普遍認為,CPO 與 NPO 將依不同應用需求並行發展,而效能、功耗、成本、部署速度及可靠性,將是評估技術導入的關鍵。會議中指出,約 83% 至 85% 的 CPO 故障與外部雷射光源(ELS)有關,另有約 11% 至 17% 涉及光纖或連接器問題,凸顯可靠性與維護仍是技術落地的重要挑戰。在系統架構方面,超過 576 顆加速器的 Scale-up 系統將朝全光學 Pod 發展,而 72 至 576 顆加速器的系統則預期由光互連與銅線互連並行支援。整體而言,光通訊已成為提升 AI 資料中心運算密度與能源效率的關鍵技術,長期來看,CPO 有望受惠於更高的整合度與頻寬需求,但短期內 NPO 憑維護彈性與 CPO 技術難點保有發展空間,兩者將依據不同應用場景與系統需求各自發展,呈現互補發展的趨勢。
思科(Cisco)推出全球首個 USFP 光通訊模組
NVIDIA 與思科(Cisco)於 2026 年 OCP Global Summit 推出共同開發新一代超高密度可插拔光模組 USFP(Ultra-Dense Small Form Factor Pluggable),瞄準每通道 400Gb/s 的電氣傳輸世代,並計畫透過開放式產業規格推動多家供應商共同參與。 在架構上,現行 OSFP 等可插拔模組主要透過沿電路板邊緣排列的接點與主機端連接器接合,當傳輸速率提高至 400G/lane,接點、連接器與走線的高頻特性便成為設計挑戰。USFP 改採二維陣列連接器,並設計兩段式插入機制,讓模組先完成定位,再接合高速接點,以改善訊號完整性並降低接點磨耗。官方資料表示,相較於每通道 200Gb/s 的可插拔光模組,USFP 預期可提升四倍頻寬密度,功耗效率則提高約 1.3 倍,模組也不需要內建專屬液冷迴路,以保留現有可插拔架構在維修與部署上的便利性。
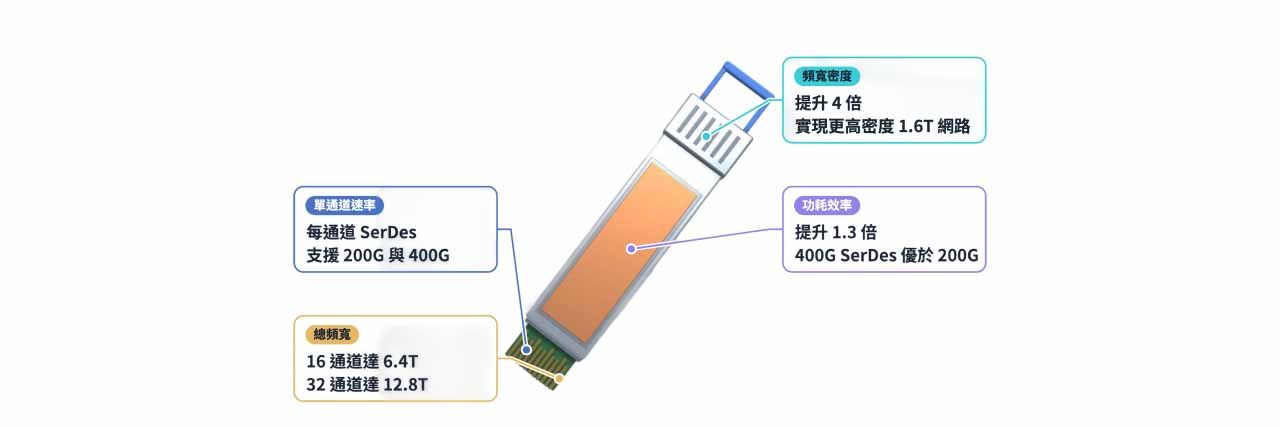
現有的方案有 OSFP 和 XPO,OSFP 優勢在於產業生態成熟、供應鏈完整,以及客戶熟悉的維修與部署流程。XPO 採用更多通道提高單一模組的總頻寬,並將液冷等散熱設計納入模組架構,追求極高的前面板頻寬密度,但也增加機構、散熱與維護複雜度。USFP 則選擇提高單通道傳輸速率,利用 400G/lane 在相近的模組體積內達到更高頻寬,同時維持可插拔的操作模式,並避免將專屬液冷迴路整合進模組。換言之,XPO 著重透過增加通道數與液冷設計提升密度,USFP 則試圖透過更高速的電氣介面,在兼顧密度、功耗與維護便利性的前提下延續可插拔架構。 此次合作對 NVIDIA 而言,USFP 有助於整合交換器與 SuperNIC,提升 AI 網路的頻寬密度,減少網路擴充層級及其電力負擔,並透過開放規格擴大硬體供應來源與客戶採用彈性。對 Cisco 而言,USFP 是其參與下一代高速乙太網路與光通訊規格的重要布局。透過與 NVIDIA 合作,Cisco 可結合 Silicon One 交換器晶片、網路設備與光學技術,強化整體解決方案能力;而多供應商生態系也有助於擴大產業參與,提升其在下一代 AI 網路供應鏈中的影響力。
整體而言,USFP 的推出反映出 AI 網路的競爭正從單純提高光模組傳輸速率,進一步延伸至電氣介面、連接器、散熱與整體系統架構的共同設計。相較於既有 OSFP 等封裝,USFP 希望以 400G/lane 提高頻寬密度,同時保留可插拔模組的維修與部署優勢,相較於採用更多通道及模組內液冷的 XPO,則選擇以更高速的單通道設計追求密度與系統簡化。
華工正源首次參加並展示 3.2T、6.4T NPO 及 12.8T XPO 解決方案
中國光通訊設備商華工科技旗下子公司華工正源,首度參加 2026 年 OCP Global Summit,展示 3.2T 高速光模組、6.4T 近封裝光學(NPO)及 12.8T 超高密度可插拔光學(XPO)三大解決方案,積極布局下一代 AI 資料中心高速光互連市場。 細看產品方面,3.2T 高速光模組採用單波 400G 技術,搭載 3 奈米/2 奈米製程 DSP 晶片,單波傳輸速率最高可達 450Gbps,並可相容既有資料中心架構,協助客戶推進網路頻寬升級。6.4T NPO 則採用無 DSP 線性直驅架構,最遠支援 500 公尺單模光纖傳輸。根據公司公布的數據,相較傳統 800G OSFP 可插拔光模組,其單位面積頻寬密度提升 11.4 倍,單位位元能耗降低 50%,有助於提升 AI 運算叢集的資料傳輸效率,同時降低高速互連的功耗負擔。至於 12.8T XPO,則採用 64 通道、單波 200G 設計,模組功耗低至 130W,並可使交換器機櫃密度提高 4 倍,進一步滿足 AI 資料中心對高頻寬、高密度及能源效率的需求。華工正源亦為 XPO MSA 標準聯盟創始成員,透過參與新一代光互連規格制定,強化在高速光通訊技術與產業標準中的布局。
除高速光模組外,華工正源也持續向上游光晶片與光源技術延伸,包括自研矽光晶片、量子點光頻梳外置光源(ELSFP),並建立磷化銦(InP)、砷化鎵(GaAs)及矽光子(SiP)三大光電子製程平台,同時布局薄膜鈮酸鋰技術,以擴大高速光晶片與光源的自主研發能力,提升關鍵元件的供應掌握度。公司於 2026 年上半年已實現 800G、1.6T 高速光模組全球規模化交貨,並持續拓展北美雲端客戶,顯示其既有高速光通訊產品已具備一定的量產與交付基礎,未來隨著 AI 模型規模擴大、運算叢集持續擴張,華工正源將持續爭取新一輪 AI 基礎設施升級所帶來的市場機會。
NVIDIA 正交背板架構升級:PTFE 高速材料與供應鏈布局
NVIDIA 新一代 AI 機櫃架構的升級,正將高速互連與 PCB 材料推向更重要的位置。隨著 Rubin Ultra 及後續 Feynman 世代朝更高 GPU 整合度與頻寬發展,NVIDIA 規劃的 Kyber 機櫃採用運算托盤垂直插入的設計,並透過正交背板連接不同運算模組,以減少傳統銅纜的使用,降低佈線複雜度與空間占用,同時改善訊號完整性及散熱配置。 由於背板與交換器板必須在極高傳輸速率下維持穩定的訊號品質,PCB 所使用的銅箔基板(CCL)材料也成為市場關注焦點。目前市場主要討論以碳氫樹脂(HC)或聚四氟乙烯(PTFE)為基礎的無玻纖布 CCL。HC 方案具備材料與製程發展潛力,但在極高頻應用下仍須克服介電損耗等電性要求。PTFE 則具備低介電損耗、低吸水率及良好的高頻穩定性,有助於降低高速訊號傳輸時的衰減,而無玻纖布結構也可減少玻纖編織造成的局部介電差異與訊號傳播時間差。不過,PTFE 仍面臨加工難度、板材尺寸穩定性、銅箔結合、製程良率及成本等挑戰。
在本次 OCP Global Summit 2026 中,NVIDIA 相關 NVLink PTFE 交換器板合作看板引起市場關注,相關供應鏈廠商包括 台虹 (8039.TW)、台郡 (6269.TW),以及中國的勝宏科技、深南電路、景旺電子、生益科技,和美國的 TTM Technologies。台廠部分,台虹的發展重點在於 PTFE 銅箔基板材料,透過 PTFE 搭配填料及無玻纖布設計,爭取新一代高速交換器板的材料需求,若相關產品順利通過客戶驗證並進入量產,將有機會提升公司在高階高速材料市場的布局。台郡則著重於軟性電路板與高速互連技術,並投入改質聚醯亞胺(PI)、液晶高分子(LCP)及 PTFE 等高階材料應用,未來若能將材料開發與電路設計能力結合,有機會切入新一代 AI 基礎設施的高階互連方案。
整體而言,PTFE 目前仍有製程、良率與成本等技術難題,但此次於 OCP 展會中出現在 NVIDIA 相關 NVLink 交換器板的合作展示,顯示其已成為新一代高速互連材料的重要發展方向。隨著 AI 機櫃持續朝更高頻寬與更高整合度演進,PTFE 有機會成為高階交換器板與背板的長期材料選項。對台廠的台虹以及台郡而言,關鍵在於 PTFE CCL 的驗證與量產進度,和觀察高階材料與互連方案能否準時導入下一代平台、不會遞延。
AI 基礎設施新趨勢:先進封裝、記憶體與機櫃架構
3.5D 先進封裝
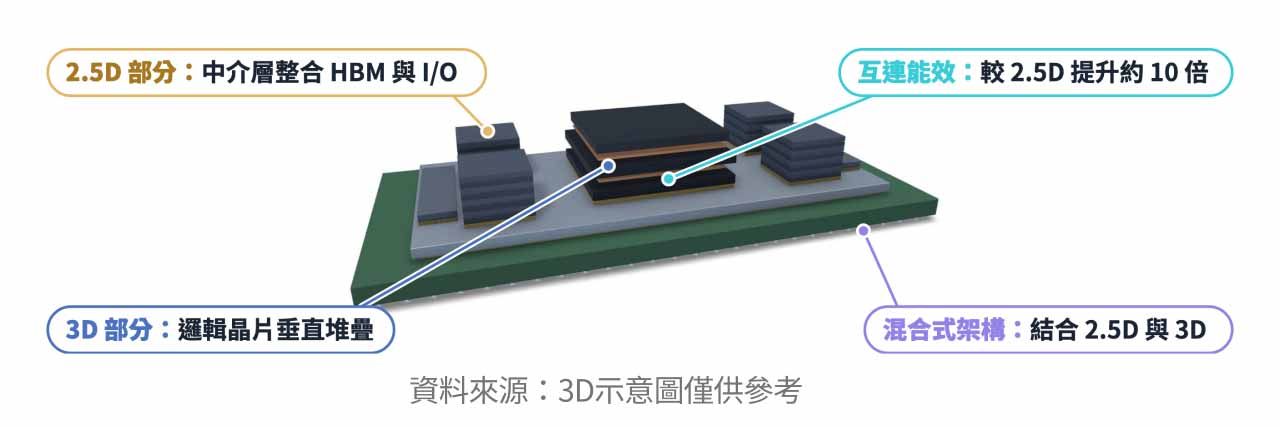
隨著 2.5D 封裝逐漸逼近物理極限,聯發科在本次 OCP Global 中表示看好 3.5D 封裝技術的發展潛力,認為其將成為延續高階晶片運算效能的重要技術。 3.5D 屬於結合 2.5D 與 3D 整合的混合式架構,透過垂直堆疊邏輯晶片,並搭配中介層整合 HBM 與 I/O 等元件,進一步提升晶片整合度與互連效率。聯發科指出,其客製化 ASIC 設計可支援接近 10 倍光罩尺寸的晶片,且 3.5D 整合的晶片間互連能效較傳統 2.5D 提升約 10 倍,預期未來 3 至 5 年相關應用將持續成長。此外,客製化 HBM 與專有晶片間互連的 DTCO(設計與製程協同最佳化)也將成為技術發展重點。隨著 AI 晶片架構日益複雜,對於資料互聯的要求越來越高,3.5D 先進封裝有望迎來更多結構性成長機會。
SK 海力士發表最新記憶體架構
為解決 AI 大規模推論面臨的記憶體容量與鍵值快取(KV-cache)瓶頸,SK 海力士高級副總裁 Kim Ho-sik 在本次 OCP Global Summit 介紹機架級記憶體系統 MARS(Memory-Centric AI Rack-Scale System),透過解耦運算與記憶體資源,建立可供多台伺服器共享的記憶體池,提升資源調度效率,降低 GPU 過度配置與整體持有成本。 此外,SK 海力士也布局高頻寬快閃記憶體(HBF),以 NAND 堆疊技術提供介於 HBM 與 SSD 之間的容量與頻寬選擇,適用於模型權重及長上下文 KV-cache 等大型推論資料。同場發表的第二代 256GB CXL 3.2 記憶體產品,則透過記憶體池化與動態分配機制,進一步提升系統擴充彈性,產品頻寬較前代提升兩倍以上,能效改善約 30%。整體而言,SK 海力士並非以 HBF 取代 HBM,而是透過 HBM、HBF 與 CXL 的分層配置,分別滿足高速運算、大容量儲存及彈性擴充需求。隨著 AI 推論與多輪對話推升記憶體需求,晶片及伺服器間的互連技術也將成為提升記憶體共享與存取效率的關鍵,帶動 AI 記憶體架構持續演進。
Agentic AI 推升 CPU 重要性,CPU Rack 成為趨勢
隨著 AI 由生成式逐步走向 Agentic AI,資料中心的運算需求也正從 GPU 推論延伸至 CPU 所負責的通用運算與任務協調。AI Agent 在執行工作時,除了需要呼叫模型進行推理,也會頻繁呼叫 API、查詢資料庫、執行程式碼及操作企業系統,當代理數量與任務並行程度提高,將進一步推升 CPU 核心、記憶體與 I/O 資源需求。 AMD 執行長蘇姿丰在本次展會的主題演講中指出,代理式 AI 帶動資料中心 CPU 市場快速擴張,公司已在過去九個月內三度上修市場預估,並預期未來四至五年市場年複合成長率約達 50%,2030 年規模將突破 2,000 億美元。為因應這項趨勢,AMD、Intel 與 NVIDIA 在本次 OCP Global Summit 不約而同地推出 CPU Rack 相關架構,AMD 的 Helion 採取彈性配置設計,提供最高 32,768 個 CPU 核心的純 CPU 機櫃,以及整合 EPYC CPU、Instinct GPU 與 Token Router 的全整合方案。Intel 則展示高密度 Xeon CPU 機櫃,部分配置可提供超過 46,000 個 CPU 核心,並採用 OCP Open Rack v3 等開放標準,強調在特定延遲要求下提升單一機櫃可同時支援的 AI Agent 數量。NVIDIA 則將 Vera CPU Rack 納入 AI Factory 架構,透過 MGX 開放式模組化平台整合運算、網路、電力與散熱,專門承擔 AI Agent 的工具呼叫、工作協調及沙盒執行,並與 Vera Rubin GPU 系統分工合作。整體而言,Agentic AI 讓 CPU 從傳統的輔助運算角色,進一步成為需要整合成專用機櫃架構,以支撐大規模代理執行的重要基礎設施。
AMD Helion 機櫃
AMD 董事長暨執行長蘇姿丰也於本次 OCP Global 以「打造下一個 AI 基礎建設時代」為題發表主題演講,聚焦機櫃級 AI 系統的發展與開放式架構的產業意義。其中,由AMD 主導設計的 Helios 機櫃採用 OCP 寬版開放機櫃標準,與 Meta 共同設計、可整合 72 顆 GPU 協同運作,並已於 2026 年 9 月開始量產出貨。此外,AMD 也推出面向代理式 AI(Agentic AI)的 Helion 機櫃,整合 CPU、GPU、液冷與 Token 路由器,預計於 11 月起供應,並將相關規格開放予 OCP 社群。 搭配預計於 2027 年上半年量產的第六代 EPYC Verano 處理器,AMD 正逐步完善從晶片到機櫃的 AI 基礎設施布局。對市場而言,Helios 的意義不僅在於提供 NVIDIA 以外的高效能 AI 系統選擇,更在於透過開放式規格與標準化設計,降低客戶對單一供應商軟硬體生態系的依賴,提升系統整合與供應鏈選擇的彈性。值得注意的是,Helion 的 13 家合作夥伴中有 8 家台灣企業,包含 鴻海 (2317.TW)、雲達(廣達旗下)、緯穎 (6669.TW)(緯創旗下)、神達 (3706.TW)、英業達 (2356.TW)、華碩 (2357.TW)、華擎 (3515.TW)、技嘉 (2376.TW),為台廠提供新的成長機會。
總結:AI 基礎設施競爭從晶片效能走向高速傳輸與系統整合
整體而言,2026 年 OCP Global Summit 反映 AI 基礎設施的競爭正從單一晶片的運算效能,進一步延伸至高速傳輸能力。隨著 GPU 數量、模型規模與 Agentic AI 工作負載持續增加,運算節點之間的資料交換量快速攀升,傳輸頻寬、延遲與能耗逐漸成為影響整體運算效率的關鍵。從 USFP、NPO、CPO 等光通訊技術,到正交背板、3.5D 先進封裝及新一代記憶體互連架構,皆顯示產業正積極突破傳統電氣介面與互連架構的限制,提升頻寬密度、降低傳輸功耗,避免資料傳輸成為 AI 算力擴張的瓶頸。未來,隨著 AI 叢集持續擴大,高速傳輸不僅是連接運算晶片的基礎,更將成為決定大規模 AI 系統效能與擴充能力的重要環節。2026 年 OCP Global Summit 的機櫃展示,也凸顯 AI 基礎設施正朝向系統性整合發展。光寶科 (2301.TW)、台達電 (2308.TW) 及 康舒 (6282.TW) 等電源廠展示 800VDC、±400V 等高壓直流供電方案,緯創 (3231.TW)、緯穎 (6669.TW) 與 華碩 (2357.TW) 則推出搭載 NVIDIA Vera Rubin 或 AMD Helios 平台的機櫃解決方案,整合運算、供電與液冷散熱。整體而言,未來 AI 基礎設施的競爭將不再侷限於晶片效能,而是延伸至供電、散熱、傳輸與運算的協同設計及整體整合能力。
